Bevor KI-Assistenten deine Seiten zitieren können, müssen sie sie erreichen und lesen. RankScan prüft das bei jedem Beim Crawling ruft ein Suchmaschinen-Bot eine URL ab und lädt deren Inhalte herunter. Es ist der erste Schritt, bevor eine Seite indexiert werden kann.Zum Glossareintrag → deiner Website. Es zeigt dafür bewusst keinen Score, sondern nur Prüfungen, die nachweislich wirken.
Die fünf Prüfungen #
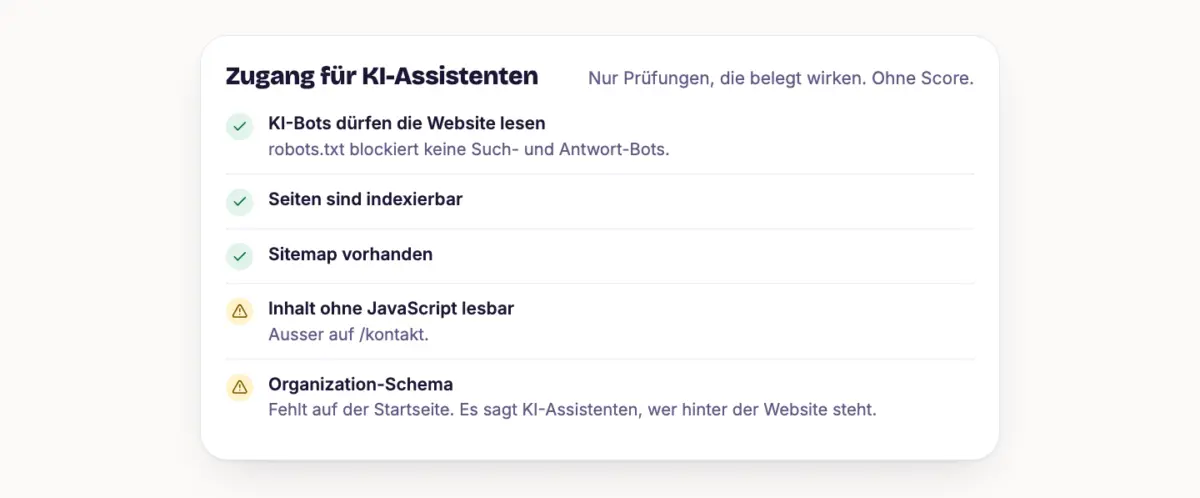
Öffne im Menü «Website Health» und die Karte «Zugang für KI-Assistenten». Jede Prüfung ist «erfüllt» oder «nicht erfüllt»:
- KI-Crawler sind automatisierte Bots, die Webseiten für KI-Anbieter abrufen, um Inhalte zu finden, für Suchfunktionen bereitzustellen, für Antworten abzurufen oder je nach Anbieter für Modelltraining zu verwenden.Zum Glossareintrag → dürfen die Website lesen Die Die robots.txt ist eine öffentlich abrufbare Textdatei im Wurzelverzeichnis einer Website. Sie teilt Crawlern mit, welche URLs sie abrufen dürfen, steuert also das Crawling.Zum Glossareintrag → blockiert keine Such- und Antwort-Bots.
- Seiten sind Bei der Indexierung verarbeitet eine Suchmaschine gecrawlte Inhalte und entscheidet, ob eine URL in den Suchindex aufgenommen wird. Nur indexierte Seiten können in den Suchergebnissen erscheinen.Zum Glossareintrag → Nur ein kleiner Teil der Seiten steht auf noindex ist eine Robots-Anweisung, die Suchmaschinen mitteilt, dass eine Seite nicht in den Suchergebnissen erscheinen soll. Die Seite muss dafür crawlbar bleiben.Zum Glossareintrag →.
- Eine XML-Sitemap ist eine maschinenlesbare Datei, die wichtige URLs einer Website auflistet. Sie hilft Suchmaschinen, Inhalte effizienter zu finden, ersetzt aber keine interne Verlinkung und garantiert keine Indexierung.Zum Glossareintrag → vorhanden Es gibt eine Extensible Markup Language (XML) ist ein flexibles Textformat zur strukturierten Speicherung und zum Austausch von Daten. Im SEO-Umfeld ist vor allem die XML-Sitemap bekannt.Zum Glossareintrag →, idealerweise mit aktuellem lastmod ist ein Element in der XML-Sitemap, das angibt, wann sich der Hauptinhalt einer URL zuletzt relevant geändert hat. Es ist nur dann nützlich, wenn es zuverlässig gepflegt wird.Zum Glossareintrag →.
- Inhalt ohne JavaScript lesbar Wichtige Inhalte stehen direkt im HyperText Markup Language (HTML) ist die Auszeichnungssprache für Webseiten. Mit ihr werden Struktur und Inhalt einer Seite definiert, etwa Überschriften, Absätze, Links und Bilder.Zum Glossareintrag →.
- Organization-Schema Die Startseite sagt in strukturierten Daten, wer hinter der Website steht.
So behebst du Blocker #
Behebe zuerst die Prüfungen, die «nicht erfüllt» sind. Blockierte Bots und nicht indexierbare Schlüsselseiten wiegen am schwersten.
Öffne danach in Website Health die Befunde zu Struktur und KI. Jeder Befund führt zur passenden Massnahme.
Ist die Website insgesamt schlecht für KI vorbereitet, erscheint unter «Massnahmen» die Aufgabe «Geringe KI-Bereitschaft». Sie nennt den schwächeren Bereich und die Schritte.
Eine llms.txt ist eine freiwillige Markdown-Datei im Root-Verzeichnis einer Website, die Sprachmodellen eine kompakte Übersicht über wichtige Inhalte gibt. Sie ist ein Vorschlag bzw. De-facto-Format, kein verbindlicher offizieller Webstandard.Zum Glossareintrag → zählt RankScan nicht. Kein KI-System liest sie nachweislich.
Alle anderen technischen Befunde erklärt Website Health lesen und Befunde beheben.
Tipp #
Erreichbarkeit ist der härteste Hebel. Blockiert die robots.txt die Bots oder lädt der Inhalt nur per JavaScript, hilft auch der beste Text wenig.
Nächster Schritt #
Welche Massnahmen du zuerst angehst, zeigt Massnahmen priorisieren und abarbeiten.