Deine Inhalte können fachlich stark, aktuell und für die Suchmaschinenoptimierung (SEO) umfasst alle Maßnahmen, mit denen eine Website in den unbezahlten (organischen) Suchergebnissen besser sichtbar wird.Zum Glossareintrag → aufbereitet sein und trotzdem in ChatGPT, Perplexity oder anderen Suchsystemen mit Künstlicher Intelligenz (KI) kaum auftauchen.
Der Grund liegt oft nicht im Content, sondern in der Technik. KI-Crawler sind automatisierte Bots, die Webseiten für KI-Anbieter abrufen, um Inhalte zu finden, für Suchfunktionen bereitzustellen, für Antworten abzurufen oder je nach Anbieter für Modelltraining zu verwenden.Zum Glossareintrag → werden durch die robots.txt, Firewalls oder das Bot-Management eines Ein Content Delivery Network (CDN) ist ein Netzwerk verteilter Server, das statische Inhalte näher beim Nutzer ausliefert und so Ladezeiten verkürzt.Zum Glossareintrag → blockiert. Ein CDN ist ein Netzwerk verteilter Server, das Seiten schneller ausliefert. Manchmal ist die Sperre gewollt. Häufig passiert sie aber unbeabsichtigt.
RankScan kennt zu diesem Thema zwei Massnahmen:
- «KI-Crawler per Die robots.txt ist eine öffentlich abrufbare Textdatei im Wurzelverzeichnis einer Website. Sie teilt Crawlern mit, welche URLs sie abrufen dürfen, steuert also das Crawling.Zum Glossareintrag → ausgeschlossen»: Die robots.txt sperrt Crawler, die für KI-Suche oder Live-Abruf zuständig sind. Findet RankScan die Sperre stattdessen in der Firewall, kann die Massnahme «KI-Crawler wahrscheinlich durch Firewall gesperrt» heissen.
- «Keine llms.txt ist eine freiwillige Markdown-Datei im Root-Verzeichnis einer Website, die Sprachmodellen eine kompakte Übersicht über wichtige Inhalte gibt. Sie ist ein Vorschlag bzw. De-facto-Format, kein verbindlicher offizieller Webstandard.Zum Glossareintrag →»: Unter
/llms.txtliegt keine Datei. Das ist eine Beobachtung, kein Fehler. Die Massnahme ist ein Hinweis ohne Handlungsbedarf.
Die Gewichtung ist klar: Gesperrte Such- und Abruf-Crawler sind ein kritisches technisches Problem. Eine fehlende llms.txt ist keines.
Die beste Lösung ist deshalb weder «alles erlauben» noch «alles sperren». Entscheide bewusst: Welche Bots dürfen für Training Beim Crawling ruft ein Suchmaschinen-Bot eine URL ab und lädt deren Inhalte herunter. Es ist der erste Schritt, bevor eine Seite indexiert werden kann.Zum Glossareintrag →? Welche Bots brauchst du für KI-Suche und Live-Abruf?
- robots.txt steuert, welche Crawler auf welche Bereiche deiner Website zugreifen dürfen.
- KI-Crawler haben drei Zwecke: Training, Suchindex und Abruf auf Anfrage einer Nutzerin. Nur die Sperre von Suchindex- und Abruf-Bots kostet KI-Sichtbarkeit beschreibt, ob und wie sichtbar eine Marke, Website oder Person in KI-generierten Antworten ist. Sie misst Erwähnung, Position, Beschreibung und Quellenverlinkung über mehrere Plattformen und Prompts hinweg.Zum Glossareintrag →. Ausnahme ist Google-Extended ist ein Produkt-Token, mit dem sich bestimmte KI-Nutzungen durch Google in der robots.txt steuern lassen. Es ist kein eigener HTTP-User-Agent und nicht mit dem Googlebot identisch.Zum Glossareintrag →: Die Sperre schliesst auch das Grounding in Gemini Apps und Vertex AI aus.
- GPTBot ist der von OpenAI dokumentierte Crawler, der typischerweise für das Training künftiger Modelle Inhalte abruft. Er lässt sich über robots.txt gezielt erlauben oder blockieren.Zum Glossareintrag →, OAI-SearchBot ist der von OpenAI dokumentierte Crawler für ChatGPT Search. Er ruft Inhalte ab, damit öffentliche Websites als Quelle in ChatGPT-Zusammenfassungen, Snippets und Antworten erscheinen können.Zum Glossareintrag → und ChatGPT-User ist der von OpenAI dokumentierte User-Agent für nutzerinitiierte Abrufe. Er ruft eine Seite ab, wenn ein Nutzer in ChatGPT eine konkrete URL oder Anfrage eingibt.Zum Glossareintrag → sind drei OpenAI-Bots mit drei Zwecken. Anthropic trennt ebenso ClaudeBot ist der von Anthropic genutzte Web-Crawler. Website-Betreiber können seinen Zugriff über die robots.txt steuern und bei Bedarf blockieren.Zum Glossareintrag →, Claude-SearchBot und Claude-User.
- Wer alle KI-Crawler pauschal blockiert, kann KI-Sichtbarkeit verlieren. Reine Trainings-Crawler wie GPTBot oder ClaudeBot kannst du sperren, ohne Sichtbarkeit in KI-Antworten zu verlieren.
- Der Googlebot ist der Webcrawler von Google, der Webseiten abruft, um sie für die Google-Suche zu crawlen und zu indexieren.Zum Glossareintrag → und Google-Extended sind nicht dasselbe. Google-Extended steuert Gemini-Training und Grounding in Gemini Apps und Vertex AI, nicht die Google-Suche und nicht AI Overviews sind von Google KI-generierte Antwortboxen, die oberhalb der klassischen Suchergebnisse erscheinen. Sie fassen Informationen aus dem Web zusammen und können die Klickverteilung verändern.Zum Glossareintrag →.
- robots.txt ist kein Sicherheitsmechanismus. Für echte Sperren braucht es Server-, CDN-, Login- oder Regeln einer Web Application Firewall (WAF).
- Ein Large Language Model (LLM), also ein grosses Sprachmodell, ist ein KI-Modell, das aus grossen Textmengen lernt und daraus formulierte Antworten erzeugt. LLMs bilden den Kern generativer Antwortsysteme wie ChatGPT, Perplexity oder Gemini.Zum Glossareintrag →.txt ist ein freiwilliger Vorschlag, kein Webstandard. Kein KI-System liest die Datei nachweislich. Lege sie nur an, wenn ein Tool oder Partner sie ausdrücklich verlangt.
Warum KI-Crawler ein Website-Health-Thema sind #
KI-Suchsysteme nutzen Webinhalte auf unterschiedliche Weise: für Training, Suche, Zusammenfassungen, Quellenlinks oder Abrufe auf Anfrage. Für Unternehmen entsteht dadurch eine neue technische Abhängigkeit.
Wenn ein Such- oder Abruf-Crawler deine Website nicht erreicht, kann das mehrere Folgen haben:
- Inhalte werden in KI-Suchsystemen nicht oder schlechter berücksichtigt.
- Deine Marke wird in Antworten nicht genannt.
- Wettbewerber erscheinen als Quelle, obwohl deine Inhalte fachlich besser wären.
- Monitoring und Optimierung werden erschwert, weil unklar ist, wo die Blockade entsteht.
Das Problem ist oft unsichtbar. Eine Seite kann in Google Bei der Indexierung verarbeitet eine Suchmaschine gecrawlte Inhalte und entscheidet, ob eine URL in den Suchindex aufgenommen wird. Nur indexierte Seiten können in den Suchergebnissen erscheinen.Zum Glossareintrag → sein und trotzdem für bestimmte KI-Crawler nicht erreichbar sein.
Typische Ursachen:
- restriktive
robots.txt, - Web Application Firewall,
- Cloudflare- oder CDN-Bot-Management,
- Rate-Limiting,
- blockierte User-Agents oder IP-Bereiche,
- Staging-Regeln, die versehentlich live geblieben sind,
- Sicherheitsplugins mit pauschalen Bot-Sperren.
Was bedeutet «KI-Crawler per robots.txt ausgeschlossen»? #
Die RankScan-Massnahme «KI-Crawler per robots.txt ausgeschlossen» bedeutet: Deine robots.txt sperrt genau die KI-Crawler, die darüber entscheiden, ob deine Website in KI-Antworten auftauchen kann. Das sind Suchindex-Crawler und Live-Abruf-Agents.
Einstufung in RankScan: Schwere kritisch · Aufwand gering · Arbeitsart Entwicklung.
Was RankScan dabei misst:
- RankScan liest bei jedem Crawl die robots.txt und vergleicht sie mit der Crawler-Liste weiter unten.
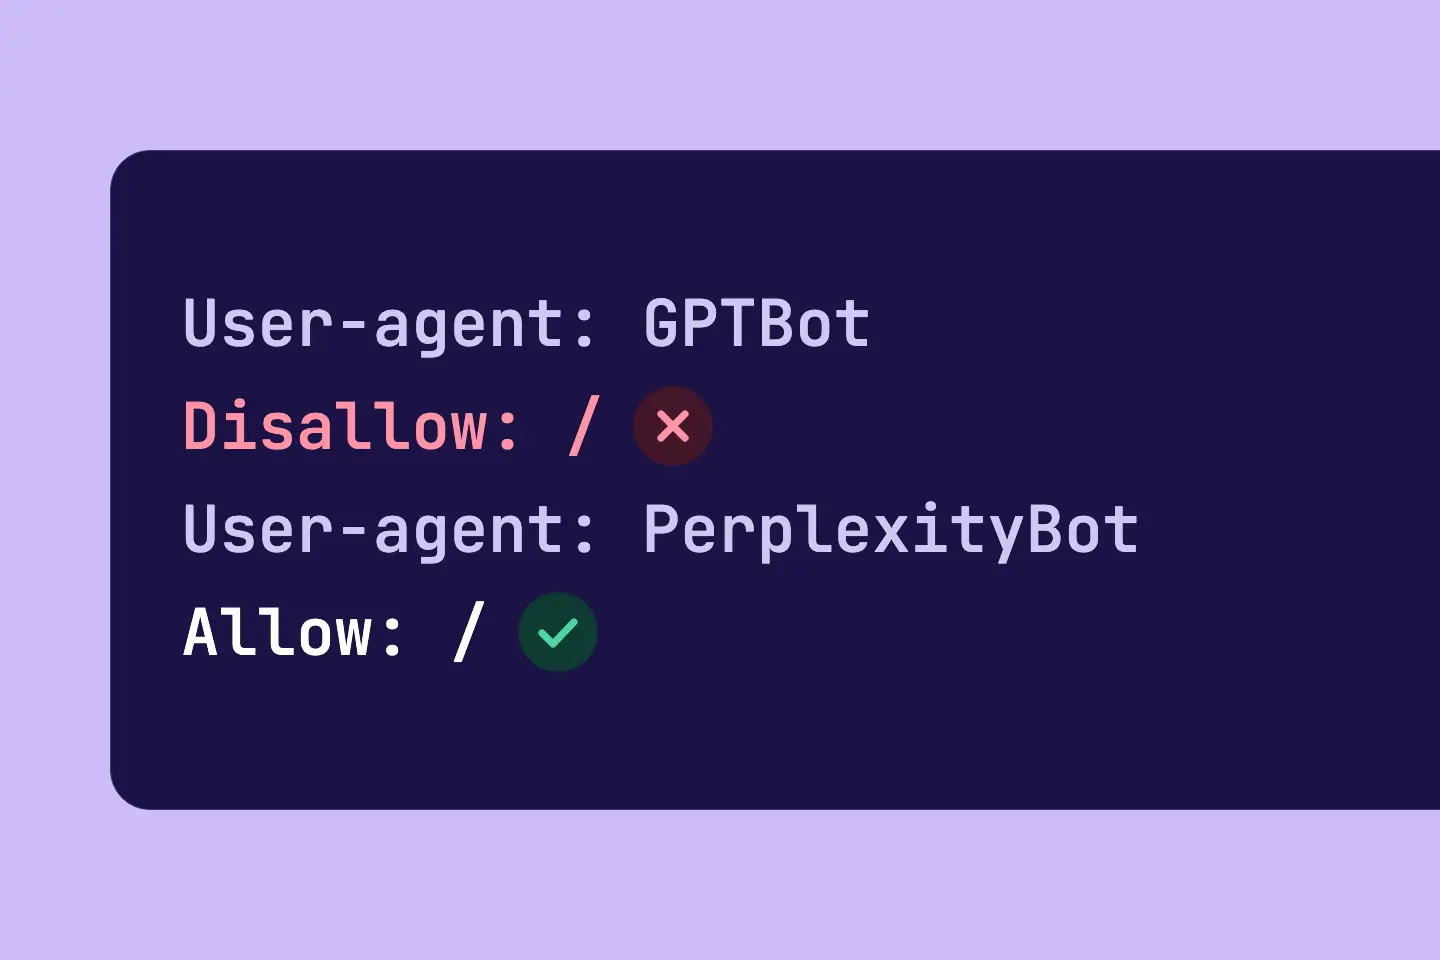
- Es zählt eine Gruppe, die den KI-Crawler mit Namen nennt und
Disallow: /enthält. Steht in derselben GruppeAllow: /, gilt die Sperre nicht. - Sperrt
User-agent: *mitDisallow: /die ganze Website, gilt jeder KI-Crawler ohne eigene Gruppe als gesperrt. Ein Crawler mit eigener Gruppe folgt nur dieser. - Eine Sperre einzelner Verzeichnisse wie
Disallow: /intern/löst die Massnahme nicht aus. - Sperrt die robots.txt nur Trainings-Crawler wie GPTBot oder ClaudeBot, entsteht keine Massnahme. Das ist eine bewusste Entscheidung und kostet keine Sichtbarkeit.
Eine selektive Freigabe trennt die Trainingsfrage von der Auffindbarkeit. Deine Inhalte bleiben zitierbar, ohne automatisch ins Modelltraining zu fliessen.
Vorgehen #
- Lass Entwicklung oder Agentur die Datei robots.txt deiner Website anpassen.
- Lass alle Such- und Abruf-Bots freigeben: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot ist der von Perplexity dokumentierte Crawler, der Websites in Perplexity-Suchergebnissen sichtbar machen und als Quelle verlinken soll. Laut Perplexity wird er nicht für das Training von Foundation Models genutzt.Zum Glossareintrag →, Perplexity-User, Applebot, meta-webindexer, meta-externalfetcher, DuckAssistBot, YouBot und MistralAI-User. Die Tabelle weiter unten zeigt, wozu jeder dieser Bots dient. RankScan zählt jeden dieser Bots mit.
- Trainings-Crawler kannst du weiterhin sperren.
- Melde die Massnahme als umgesetzt, sobald die neue Datei online ist.
Prüfweg: Der nächste Crawl liest die robots.txt vollständig, auch wenn er nicht alle Seiten erreicht. RankScan meldet dann «Behoben» oder «Noch nicht behoben».
Variante: «KI-Crawler wahrscheinlich durch Firewall gesperrt» #
RankScan führt diese Prüfung schrittweise ein. Sie erscheint noch nicht in jedem Konto.
Die robots.txt kann sauber sein, und trotzdem kommen KI-Crawler nicht durch. Dann sperrt meist eine Firewall oder das Bot-Management eines CDN.
So erkennt RankScan diesen Fall:
- RankScan ruft die Startseite einmal als eigener Crawler ab. Dieser Abruf dient als Kontrolle.
- Danach ruft RankScan dieselbe Seite als OAI-SearchBot, PerplexityBot und Claude-SearchBot ab. Agents, die die robots.txt sperrt, ruft RankScan nicht ab. Sperrt die robots.txt den Agent für die ganze Website, gilt die robots.txt-Massnahme. Das gilt auch für eine Sperre über
User-agent: *. - Erhält die Kontrolle die Seite, ein KI-Crawler aber nicht, meldet RankScan eine wahrscheinliche Sperre. Aus den Antwort-Headern liest RankScan, welcher Dienst sperrt, etwa Cloudflare.
- Hat ein KI-Assistent in den letzten 30 Tagen eine Seite deiner Website zitiert, gilt sein Crawler nicht als gesperrt. CDNs erkennen echte Bots oft an der IP-Adresse und lassen nur diese durch.
- Scheitert die Kontrolle oder antwortet der Server mit einem Fehler, misst RankScan in diesem Lauf nichts.
Einstufung in RankScan: Sind alle drei Crawler gesperrt, ist die Schwere kritisch. Bei einem oder zwei ist sie hoch. Aufwand gering · Arbeitsart Entwicklung.
Die Sperre trifft nur KI-Crawler. Besucherinnen und Google sehen die Website normal. Darum fällt sie selten auf.
- Lass Entwicklung oder Agentur die Bot-Einstellungen deines CDN oder deiner Firewall prüfen.
- Gib OAI-SearchBot, Claude-SearchBot, PerplexityBot, ChatGPT-User und Claude-User frei.
- Trainings-Crawler wie GPTBot und ClaudeBot kannst du weiter sperren.
- Melde die Massnahme als umgesetzt, sobald die Einstellung gespeichert ist.
Prüfweg: RankScan ruft die Startseite im nächsten Lauf erneut als KI-Crawler ab.
Was sind KI-Crawler? #
KI-Crawler oder AI Crawler (AI steht für Artificial Intelligence, englisch für Künstliche Intelligenz) sind automatisierte Bots, die Webseiten abrufen. KI-Anbieter nutzen sie, um Inhalte zu finden, für Suchfunktionen bereitzustellen, für Antworten abzurufen oder für Modelltraining zu verwenden.
OpenAI unterscheidet in der eigenen Dokumentation mehrere User-Agents, darunter GPTBot, OAI-SearchBot und ChatGPT-User. Diese erfüllen unterschiedliche Aufgaben und lassen sich über robots.txt getrennt steuern.
Quelle: OpenAI Platform: Overview of OpenAI Crawlers
Für Website-Betreiber ist diese Unterscheidung zentral. Wer pauschal alle OpenAI-Bots blockiert, blockiert nicht nur Training, sondern auch Such- und Abruffunktionen, die für Sichtbarkeit in ChatGPT relevant sind.
Training, Suchindex und Abruf: Der entscheidende Unterschied #
Nicht jeder KI-Bot macht dasselbe. Für eine sinnvolle robots.txt-Strategie unterscheidest du drei Zwecke.
1. Training #
Beim Training fliessen Inhalte in zukünftige KI-Modelle. Dafür stehen Crawler wie GPTBot oder ClaudeBot.
OpenAI schreibt: Wer GPTBot sperrt, signalisiert, dass die Inhalte nicht für das Training von Foundation Models genutzt werden sollen.
Quelle: OpenAI Platform: Overview of OpenAI Crawlers
User-agent: GPTBot
Disallow: /
Das kann aus rechtlichen, strategischen oder publizistischen Gründen sinnvoll sein. Eine Trainingssperre kostet keine Sichtbarkeit in KI-Antworten. Ausnahme ist Google-Extended: Die Sperre schliesst auch das Grounding in Gemini Apps und Vertex AI aus. In RankScan senkt die Sperre den Score nicht.
2. Suchindex #
Suchindex-Crawler bauen den Index auf, aus dem ein KI-Produkt antwortet. Dazu gehören OAI-SearchBot von OpenAI, Claude-SearchBot von Anthropic und PerplexityBot von Perplexity. Wer sie sperrt, fällt als Quelle weg.
OpenAI schreibt: Seiten, die OAI-SearchBot ausschliessen, erscheinen nicht in den Antworten der ChatGPT-Suche.
Quelle: OpenAI Platform: Overview of OpenAI Crawlers
Anthropic schreibt: Eine Sperre von Claude-SearchBot verhindert, dass Claude deine Inhalte für die Suche indexiert.
Quelle: Anthropic Support: Does Anthropic crawl data from the web?
Perplexity beschreibt den PerplexityBot als Crawler, der Websites in Perplexity-Suchergebnissen zeigt und verlinkt. Laut Perplexity dient dieser Bot nicht dem Training von Foundation Models.
Quelle: Perplexity Docs: Perplexity Crawlers
Nicht jeder Assistent hat einen eigenen Suchindex-Crawler. Microsoft Copilot stützt sich auf den Bing-Index, den Bingbot aufbaut. Für die Websuche von ChatGPT gilt das nach verbreiteter Ansicht ebenfalls, gesichert ist es nicht. Lass Bingbot darum zu. Was Bing von deiner Website kennt, zeigen die Bing Webmaster Tools.
3. Abruf auf Anfrage #
Abruf-Bots holen eine Seite live, während ein KI-Assistent einer Nutzerin antwortet. Dazu gehören ChatGPT-User, Claude-User und Perplexity-User.
Eine Nutzerin gibt zum Beispiel deine URL in ChatGPT ein und erwartet eine Zusammenfassung. Ob eine Sperre in robots.txt den Abruf verhindert, hängt vom Anbieter ab. Laut Anthropic verhindert eine Sperre von Claude-User, dass Claude deine Inhalte für eine Nutzeranfrage abruft.
Quelle: Anthropic Support: Does Anthropic crawl data from the web?
OpenAI und Perplexity weisen darauf hin, dass ihre Abruf-Bots robots.txt-Regeln nicht in jedem Fall befolgen. Der Grund: Eine Nutzerin hat den Abruf ausgelöst.
Quellen: OpenAI Platform: Overview of OpenAI Crawlers, Perplexity Docs: Perplexity Crawlers
robots.txt: Was sie kann und was nicht #
Die robots.txt liegt im Root-Verzeichnis deiner Website:
https://example.ch/robots.txtSie gibt Crawlern Hinweise, welche Bereiche sie abrufen dürfen und welche nicht. Google beschreibt robots.txt als Werkzeug zur Steuerung von Crawler-Traffic, nicht als Methode, um Webseiten sicher aus Google oder aus dem Web herauszuhalten.
Quelle: Google Search Central: robots.txt Introduction and Guide
Ein einfaches Beispiel:
User-agent: *
Disallow: /intern/

Sitemap: https://example.ch/sitemap.xml
Das bedeutet: Kooperierende Crawler sollen /intern/ nicht abrufen. Die Sitemap zeigt zusätzlich, wo wichtige indexierbare URLs zu finden sind. Wie robots.txt und noindex ist eine Robots-Anweisung, die Suchmaschinen mitteilt, dass eine Seite nicht in den Suchergebnissen erscheinen soll. Die Seite muss dafür crawlbar bleiben.Zum Glossareintrag → zusammenspielen, erklärt der Artikel zu noindex und robots.txt.
Wichtig:
- robots.txt basiert auf Kooperation.
- Seriöse Crawler respektieren sie meist.
- Nicht alle Bots halten sich zuverlässig daran.
- Vertrauliche Inhalte dürfen nicht nur über robots.txt geschützt werden.
- Für jeden Crawler gilt nur eine Gruppe: die mit dem passendsten User-Agent. Alle anderen Gruppen ignoriert er, auch
User-agent: *.
Quelle: Google Search Central: How Google interprets the robots.txt specification
Eine Studie von 2025 untersuchte die robots.txt-Compliance verschiedener Scraper. Sie kam zum Schluss, dass sich nicht alle Bot-Kategorien zuverlässig an robots.txt halten. Verstehe robots.txt deshalb nicht als alleinigen Schutzmechanismus.
Quelle: arXiv: Scrapers selectively respect robots.txt directives
Die wichtigsten KI-Crawler und User-Agents #
Die Tabelle folgt der Liste, mit der RankScan deine robots.txt liest. Sie ordnet jeden User-Agent einem Zweck zu. Nur eine Sperre von Suchindex- oder Abruf-Bots löst die Massnahme «KI-Crawler per robots.txt ausgeschlossen» aus.
| User-Agent | Anbieter | Zweck | Folge einer Sperre |
|---|---|---|---|
GPTBot | OpenAI | Training | Keine Folge für KI-Antworten |
ClaudeBot | Anthropic | Training | Keine Folge für KI-Antworten |
Google-Extended | Training und Grounding | Kein Gemini-Training und kein Grounding in Gemini Apps und Vertex AI. Keine Folge für Aufnahme und Ranking in der Google-Suche | |
Applebot-Extended | Apple | Training | Keine Folge für KI-Antworten |
meta-externalagent | Meta | Training | Keine Folge für KI-Antworten |
Amazonbot, bedrockbot | Amazon | Training | Keine Folge für KI-Antworten |
CCBot, Bytespider, cohere-ai, AI2Bot, Diffbot, omgilibot | diverse | Training | Keine Folge für KI-Antworten |
anthropic-ai, Claude-Web | Anthropic | Training (veraltet) | Keine Folge für KI-Antworten |
OAI-SearchBot | OpenAI | Suchindex | Keine Quelle mehr in der ChatGPT-Suche |
Claude-SearchBot | Anthropic | Suchindex | Keine Quelle mehr in der Claude-Suche |
PerplexityBot | Perplexity | Suchindex | Keine Quelle mehr in Perplexity |
Applebot | Apple | Suchindex | Keine Quelle mehr in Apple-Diensten |
meta-webindexer | Meta | Suchindex | Keine Quelle mehr in Meta AI |
DuckAssistBot | DuckDuckGo | Suchindex | Keine Quelle mehr in DuckAssist |
YouBot | You.com | Suchindex | Keine Quelle mehr in You.com |
ChatGPT-User | OpenAI | Abruf | Kein verlässlicher Ausschluss: OpenAI wendet robots.txt bei Nutzerabrufen nicht immer an. Keine Folge für die ChatGPT-Suche |
Claude-User | Anthropic | Abruf | Laut Anthropic ruft Claude die Seite für Nutzeranfragen nicht mehr ab |
Perplexity-User | Perplexity | Abruf | Kein verlässlicher Ausschluss: Perplexity ignoriert robots.txt bei Nutzerabrufen in der Regel |
meta-externalfetcher | Meta | Abruf | Wirkt nur, wenn Der Meta-Robots-Tag ist ein HTML-Element im <head> einer Seite, das Suchmaschinen Anweisungen zur Indexierung und Linkverfolgung gibt, etwa noindex oder nofollow.Zum Glossareintrag →.txt bei Nutzerabrufen befolgt |
MistralAI-User | Mistral | Abruf | Wirkt nur, wenn Mistral robots.txt bei Nutzerabrufen befolgt |
Bei Abruf-Bots ist robots.txt kein verlässlicher Ausschluss. Eine Nutzerin löst den Abruf aus, und manche Anbieter wenden robots.txt dann nicht an. Willst du einen Zugriff sicher verhindern, sperre ihn serverseitig, etwa über Firewall oder Zugriffsschutz. Die Aufnahme in die ChatGPT-Suche steuerst du über OAI-SearchBot, nicht über ChatGPT-User.
anthropic-ai und Claude-Web setzt Anthropic nicht mehr ein. Sie stehen aber noch in vielen robots.txt-Dateien. RankScan erkennt sie deshalb weiter.
Den normalen Googlebot führt die Liste nicht. Er ist kein KI-Crawler im Sinn dieser Massnahme. Sperrst du ihn, verlierst du die klassische Google-Suche.
Googlebot vs. Google-Extended: Der häufigste Fehler #
Ein besonders wichtiger Punkt ist die Unterscheidung zwischen Googlebot und Google-Extended.
- Googlebot ist für die klassische Google-Suche relevant.
- Google-Extended ist ein Steuerungstoken für bestimmte KI-Nutzungen durch Google.
Google erklärt, dass Google-Extended kein separater User-Agent ist. Crawling erfolgt über bestehende Google-User-Agents; Google-Extended dient in robots.txt als Produkt-Token. Laut Google steuert Google-Extended, ob Inhalte für das Training künftiger Gemini-Modelle genutzt werden. Es steuert zudem das Grounding in Gemini Apps und in «Grounding with Google Search» auf Vertex AI. Grounding heisst: Das Modell erhält bei einer Anfrage Inhalte aus dem Google-Suchindex. Google-Extended beeinflusst laut Google weder die Aufnahme in die Google-Suche noch das Ranking.
Quelle: Google Crawling Infrastructure: Google-Extended
Beispiel:
User-agent: Google-Extended
Disallow: /
Diese Regel ist etwas anderes als:
User-agent: Googlebot
Disallow: /
Die zweite Regel gefährdet deine klassische Google-Sichtbarkeit. Deshalb gilt:
Wenn du Google-KI-Nutzung einschränken willst, blockiere nicht versehentlich den Googlebot.
Google AI Overviews und AI Mode gehören zur Google-Suche. Google-Extended steuert sie laut Google nicht. Für diese Funktionen gelten die Steuerungen der Suche: robots.txt für den Googlebot, nosnippet, data-nosnippet, max-snippet und noindex.
Quelle: Google Search Central: AI features and your website
GPTBot robots.txt: OpenAI richtig steuern #
Behandle die OpenAI-Crawler getrennt. Viele Unternehmen wollen Training einschränken, aber Sichtbarkeit in KI-Suche erhalten:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /
Das ist oft sinnvoller als eine pauschale Sperre aller OpenAI-Crawler. Für Anthropic gilt dasselbe Muster mit ClaudeBot, Claude-SearchBot und Claude-User.
Drei Strategien für robots.txt und KI-Crawler #
Es gibt keine universell richtige Einstellung. Die passende Strategie hängt davon ab, wie offen deine Inhalte genutzt werden dürfen.
Strategie A: Maximale KI-Sichtbarkeit #
Diese Strategie eignet sich für Websites, die möglichst offen für KI-Systeme sein möchten. Ohne Sperre gilt für alle Bots die allgemeine Gruppe:
User-agent: *
Allow: /

Sitemap: https://example.ch/sitemap.xml
Geeignet für:
- Ratgeberportale,
- SaaS-Websites,
- öffentliche Dokumentationen,
- Unternehmen mit starkem Thought-Leadership-Fokus,
- Marken, die maximale Auffindbarkeit wollen.
Risiko: Inhalte können je nach Anbieter auch ins Training fliessen.
Strategie B: Training blockieren, KI-Suche erlauben #
Diese Strategie eignet sich für Unternehmen, die Inhalte nicht für Modelltraining freigeben möchten, aber in KI-Antworten sichtbar bleiben wollen. Beachte: Die Sperre von Google-Extended schliesst auch das Grounding in Gemini Apps und Vertex AI aus, nicht nur das Training. Willst du in Gemini Apps sichtbar bleiben, lass Google-Extended offen. In RankScan senkt die Sperre den Score nicht.
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: ChatGPT-User
User-agent: Claude-User
User-agent: Perplexity-User
Allow: /

Sitemap: https://example.ch/sitemap.xml
Geeignet für:
- B2B-Unternehmen,
- Publisher mit differenzierter Datenstrategie,
- Marken mit hohem Content-Wert.
Risiko: Die genaue Trennung zwischen Training, Suche und Abruf hängt vom jeweiligen Anbieter ab und kann sich ändern.
Strategie C: Sensible Bereiche schützen #
Diese Strategie eignet sich für Websites, bei denen öffentliche Inhalte sichtbar bleiben sollen, aber einzelne Bereiche nicht gecrawlt werden dürfen.
User-agent: *
Disallow: /intern/
Disallow: /staging/
Disallow: /downloads/vertraulich/

Sitemap: https://example.ch/sitemap.xml
Gib einem KI-Crawler hier keine eigene Gruppe mit Allow: /. Er würde sonst die allgemeine Gruppe ignorieren und die gesperrten Bereiche abrufen. Brauchst du doch eine eigene Gruppe, wiederhole darin die Disallow-Zeilen.
Wichtig: Vertrauliche Inhalte dürfen nicht nur über robots.txt geschützt werden. Wenn Inhalte wirklich privat sind, braucht es Login-Schutz, serverseitige Regeln oder WAF-Konfigurationen.
Was ist eine llms.txt? #
Die llms.txt ist eine Markdown-Datei im Root-Verzeichnis einer Website:
https://example.ch/llms.txtSie soll Sprachmodellen eine kompakte Übersicht über wichtige Inhalte geben. Die Idee hat Jeremy Howard von Answer.AI 2024 vorgeschlagen. Die Datei soll grossen Sprachmodellen (Large Language Models, LLMs) helfen, relevante Inhalte einer Website schneller zu erfassen.
Quellen: llms.txt: The /llms.txt file, Answer.AI: /llms.txt proposal
Die realistische Einordnung: llms.txt ist ein freiwilliger Vorschlag, kein Webstandard. Kein KI-System liest die Datei nachweislich. Sie verändert deine Sichtbarkeit in Suchmaschinen und KI-Antworten nicht.
| Merkmal | robots.txt | llms.txt |
|---|---|---|
| Zweck | Zugriff steuern | Inhalte beschreiben |
| Frage | Darf ein Bot crawlen? | Welche Inhalte sind wichtig? |
| Format | Text-Direktiven | Markdown |
| Status | Etablierter Standard | Freiwilliger Vorschlag |
| Wirkung | Kooperierende Bots halten sich daran | Keine nachgewiesene Wirkung |
| Speicherort | /robots.txt | /llms.txt |
Was bedeutet «Keine llms.txt»? #
Die RankScan-Massnahme «Keine llms.txt» bedeutet: Unter /llms.txt liegt keine Datei. Das ist eine Beobachtung, kein Fehler.
Einstufung in RankScan: Schwere niedrig · Aufwand gering · Arbeitsart Entwicklung. Die Massnahme ist ein Hinweis ohne Handlungsbedarf. Sie zählt nicht zu deinen offenen Massnahmen.
Vorgehen #
- Prüfe, ob ein Tool oder Partner die Datei llms.txt ausdrücklich verlangt.
- Ist das nicht der Fall, ignoriere die Massnahme.
- Sonst lass Entwicklung oder Agentur die Datei unter
/llms.txtanlegen, nach den Vorgaben des Tools oder Partners. - Melde die Massnahme als umgesetzt.
Prüfweg: Der nächste Crawl prüft die Datei, auch wenn er nicht alle Seiten erreicht.
Legst du die Datei an, gilt: Sie ist öffentlich. Nenne darin keine internen Adressen und keine vertraulichen Informationen.
Worauf ein KI-Crawler-Check allgemein achtet #
Die folgende Liste ist eine allgemeine Checkliste. Sie geht über das hinaus, was RankScan misst.
- Ist
/robots.txterreichbar? - Gibt es pauschale Sperren für alle Bots?
- Werden Suchindex- oder Abruf-Bots explizit blockiert?
- Ist
Googlebotversehentlich von KI-Regeln betroffen? - Wird
Google-Extendedkorrekt verwendet? - Sind Training, Suchindex und Abruf getrennt geregelt?
- Ist die Eine XML-Sitemap ist eine maschinenlesbare Datei, die wichtige URLs einer Website auflistet. Sie hilft Suchmaschinen, Inhalte effizienter zu finden, ersetzt aber keine interne Verlinkung und garantiert keine Indexierung.Zum Glossareintrag → in robots.txt referenziert?
- Erhalten KI-Crawler in den Server-Logs 401, 403, 429 oder 5xx?
- Blockiert eine Firewall relevante Bots trotz erlaubender robots.txt?
RankScan misst davon zwei Punkte. Erstens liest RankScan die robots.txt und meldet Sperren von Suchindex- und Abruf-Bots der ganzen Website. Zweitens ruft RankScan in der Firewall-Variante die Startseite als KI-Crawler ab. Server-Logs, Rate-Limits und Unterseiten prüft RankScan nicht.
So prüfst du, ob KI-Crawler blockiert werden #
1. robots.txt direkt aufrufen #
Rufe im Browser auf:
https://deine-domain.ch/robots.txtSuche nach Regeln wie:
User-agent: OAI-SearchBot
Disallow: /
oder:
User-agent: *
Disallow: /
Solche Regeln sperren KI-Crawler komplett. Die zweite Regel sperrt alle Bots, die keine eigene Gruppe haben.
2. Server-Logs prüfen #
In den Server-Logs siehst du, welche Bots deine Website besuchen und welche Statuscodes sie erhalten.
Wichtige Statuscodes:
| Statuscode | Bedeutung |
|---|---|
| 200 | Zugriff erfolgreich |
| 301/302 | Weiterleitung |
| 401 | Authentifizierung nötig |
| 403 | Zugriff verboten |
| 404 | URL nicht gefunden |
| 429 | Zu viele Anfragen |
| 5xx | Serverfehler |
Wenn OAI-SearchBot, PerplexityBot oder andere Such- und Abruf-Bots wiederholt 403 erhalten, ist das ein klares Warnsignal.
3. Firewall, CDN und Bot-Management prüfen #
Viele Sperren entstehen nicht in der robots.txt, sondern auf Infrastruktur-Ebene.
Typische Systeme:
- Cloudflare,
- Akamai,
- Fastly,
- WordPress-Security-Plugins,
- Bot-Management-Regeln,
- Rate-Limiting,
- Sperren nach Land oder nach Autonomous System Number (ASN), der Kennung eines Netzbereichs.
Cloudflare bietet eine verwaltete robots.txt an. In der Grundeinstellung sperrt sie nur Trainings-Crawler wie GPTBot, ClaudeBot und Google-Extended. Diese Sperre löst in RankScan keine Massnahme aus. Beachte: Die Sperre von Google-Extended schliesst auch das Grounding in Gemini Apps und Vertex AI aus. Stellst du dort auch die Richtlinie für Suche auf «Block», trifft die Sperre Such-Bots. Dann kann RankScan die Massnahme melden.
Quelle: Cloudflare Docs: Managed robots.txt
Häufige Fehler bei robots.txt und KI-Crawlern #
Fehler 1: Alle Bots blockieren #
User-agent: *
Disallow: /
Diese Regel ist für Staging-Websites sinnvoll. Auf einer Live-Website verhindert sie klassische SEO- und KI-Sichtbarkeit. RankScan meldet sie als «KI-Crawler per robots.txt ausgeschlossen».
Fehler 2: Googlebot statt Google-Extended blockieren #
Wer Googlebot blockiert, gefährdet die klassische Google-Suche. Wer Gemini-Training und Grounding in Gemini Apps und Vertex AI steuern will, setzt Google-Extended ein. AI Overviews und AI Mode steuert Google-Extended nicht.
Fehler 3: Training und Suche gleich behandeln #
Viele Teams sperren alle Bots eines Anbieters zusammen. Für Sichtbarkeit in ChatGPT, Claude und Perplexity brauchst du aber die Suchindex- und Abruf-Bots: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User und PerplexityBot.
Fehler 4: robots.txt als Sicherheitssystem betrachten #
robots.txt ist kein Schutz für vertrauliche Inhalte. Wer sensible Daten schützen will, braucht serverseitige Zugriffskontrolle.
Fehler 5: llms.txt als Hebel verkaufen #
Kein KI-System liest llms.txt nachweislich. Die Datei bringt weder bessere Rankings noch mehr Erwähnungen in KI-Antworten. Investiere die Zeit lieber in die Erreichbarkeit für Such- und Abruf-Bots.
Fehler 6: Firewall vergessen #
Eine robots.txt kann korrekt aussehen, während eine WAF trotzdem blockiert. Ohne Server-Logs oder einen Abruf als KI-Crawler bleibt das Problem oft unsichtbar.
Beispiel: Wenn die Firewall KI-Sichtbarkeit verhindert #
Ein B2B-Unternehmen rankt in Google gut, wird aber in ChatGPT und Perplexity kaum als Quelle genannt.
Die robots.txt sieht sauber aus:
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Trotzdem zeigen die Server-Logs:
OAI-SearchBot    403 Forbidden
PerplexityBot    403 Forbidden
Die Ursache liegt nicht in der robots.txt, sondern in der Web Application Firewall. Sie blockiert unbekannte Bots automatisch. In RankScan kann dieser Fall als «KI-Crawler wahrscheinlich durch Firewall gesperrt» erscheinen.
Die Lösung:
- Lass Entwicklung oder Agentur die Bot-Einstellungen der Firewall prüfen.
- Gib OAI-SearchBot, Claude-SearchBot, PerplexityBot, ChatGPT-User und Claude-User frei.
- Trainings-Crawler wie GPTBot und ClaudeBot kannst du weiter sperren.
- Melde die Massnahme als umgesetzt, sobald die Einstellung gespeichert ist.
Das Beispiel zeigt: KI-Sichtbarkeit ist nicht nur Content-Optimierung. Sie beginnt bei technischer Erreichbarkeit.
Checkliste: KI-Crawler bewusst steuern #
Prüfe für deine Website:
- Ist
/robots.txterreichbar? - Ist die Sitemap in robots.txt verlinkt?
- Gibt es eine pauschale Sperre über
User-agent: *? - Wird der normale
Googlebotblockiert? - Wird
Google-Extendedbewusst eingesetzt? - Sind Training, Suchindex und Abruf getrennt geregelt?
- Sind
OAI-SearchBot,Claude-SearchBotundPerplexityBoterlaubt? - Sind
ChatGPT-UserundClaude-Usererlaubt? - Gibt es WAF-, CDN- oder Security-Regeln, die KI-Bots blockieren?
- Erhalten Such- und Abruf-Bots in den Server-Logs den Der HTTP-Status 200 (OK) bedeutet, dass eine Seite erfolgreich gefunden und ausgeliefert wurde. Nur 200-URLs sollten in der Sitemap stehen und als Canonical-Ziel dienen.Zum Glossareintrag →?
Ergänzend dazu helfen AI Readiness Score und JavaScript-SEO, um die Ursache sauber einzugrenzen und die nächsten SEO-Massnahmen zu priorisieren.
Häufige Fragen zu llms.txt, robots.txt und KI-Crawlern #
Was ist eine llms.txt?
Eine llms.txt ist eine Markdown-Datei im Root-Verzeichnis einer Website. Sie soll Sprachmodellen eine kurze Übersicht über wichtige Inhalte, Themen und Links geben.
Ist llms.txt ein offizieller Standard?
Nein. llms.txt ist ein freiwilliger Vorschlag. Kein KI-System liest die Datei nachweislich.
Was ist der Unterschied zwischen robots.txt und llms.txt?
robots.txt steuert den Zugriff von Crawlern, und kooperierende Bots halten sich daran. llms.txt soll Sprachmodellen Inhalte beschreiben, hat aber keine nachgewiesene Wirkung.
Kann ich mit robots.txt KI-Crawler blockieren?
Ja, kooperierende Crawler lassen sich über robots.txt blockieren. Abruf-Bots wie ChatGPT-User befolgen die Regeln laut Anbieter nicht in jedem Fall. Für echte Zugriffssicherheit reichen robots.txt-Regeln nicht aus.
Sollte ich GPTBot blockieren?
Das hängt von deiner Strategie ab. Wenn du Training verhindern willst, kannst du GPTBot blockieren. Das kostet keine Sichtbarkeit in KI-Antworten. Verwechsle GPTBot nicht mit OAI-SearchBot oder ChatGPT-User.
Verliere ich Google-Rankings, wenn ich Google-Extended blockiere?
Nein. Laut Google beeinflusst Google-Extended weder die Aufnahme in die Google-Suche noch das Ranking. Die Sperre wirkt aber über das Training hinaus: Gemini Apps und Vertex AI nutzen deine Inhalte dann auch nicht mehr für Grounding. Blockiere nicht versehentlich den Googlebot.
Muss jede Website eine llms.txt haben?
Nein. Lege die Datei nur an, wenn ein Tool oder Partner sie ausdrücklich verlangt.
Wie finde ich heraus, ob KI-Crawler meine Website besuchen?
Am zuverlässigsten über Server-Logs. Dort siehst du User-Agent, URL, Zeitpunkt und Statuscode.
Was bedeutet «KI-Crawler per robots.txt ausgeschlossen»?
Die Massnahme bedeutet: Deine robots.txt sperrt mindestens einen Suchindex- oder Abruf-Bot für die ganze Website. Das gilt auch für eine Sperre über User-agent: *. RankScan stuft sie als kritisch ein. Findet RankScan die Sperre in der Firewall statt in der robots.txt, kann die Massnahme «KI-Crawler wahrscheinlich durch Firewall gesperrt» heissen.
Was bedeutet «Keine llms.txt»?
Die Massnahme bedeutet: Unter /llms.txt liegt keine Datei. Das ist eine Beobachtung, kein Fehler. Es besteht kein Handlungsbedarf.
Reicht eine llms.txt für ChatGPT SEO?
Nein. Für Sichtbarkeit in KI-Antworten brauchst du gute, aktuelle Inhalte, die Such- und Abruf-Bots erreichen können. Eine llms.txt ändert daran nichts.
Fazit: KI-Crawler bewusst steuern statt zufällig blockieren #
KI-Sichtbarkeit entsteht nicht nur durch gute Inhalte. Sie setzt voraus, dass KI-Systeme deine Inhalte technisch erreichen.
Die wichtigste Massnahme ist deshalb die technische Prüfung:
- Können Suchindex- und Abruf-Bots deine Website abrufen?
- Werden sie durch robots.txt blockiert?
- Werden sie durch Firewall, CDN oder Bot-Management blockiert?
- Sind Training, Suchindex und Abruf sauber getrennt?
robots.txt ist die Zugriffskontrolle.
Server-Logs und WAF-Regeln zeigen, was wirklich passiert.
Eine llms.txt kann warten, bis ein Tool oder Partner sie verlangt.
Für viele Unternehmen ist die beste Strategie eine differenzierte Steuerung:
- Training bewusst erlauben oder blockieren,
- Suchindex und Abruf ermöglichen,
- sensible Bereiche technisch schützen,
- Server-Logs und WAF-Regeln regelmässig prüfen.
So verhinderst du, dass deine Website unbeabsichtigt für KI-Systeme unsichtbar wird.
Quellen und weiterführende Informationen #
- OpenAI Platform: Overview of OpenAI Crawlers
- Google Search Central: robots.txt Introduction and Guide
- Google Search Central: How Google interprets the robots.txt specification
- Google Crawling Infrastructure: Google-Extended
- Anthropic Support: Does Anthropic crawl data from the web?
- Perplexity Docs: Perplexity Crawlers
- Cloudflare Docs: Managed robots.txt
- llms.txt: The /llms.txt file
- Answer.AI: /llms.txt proposal
- arXiv: Scrapers selectively respect robots.txt directives