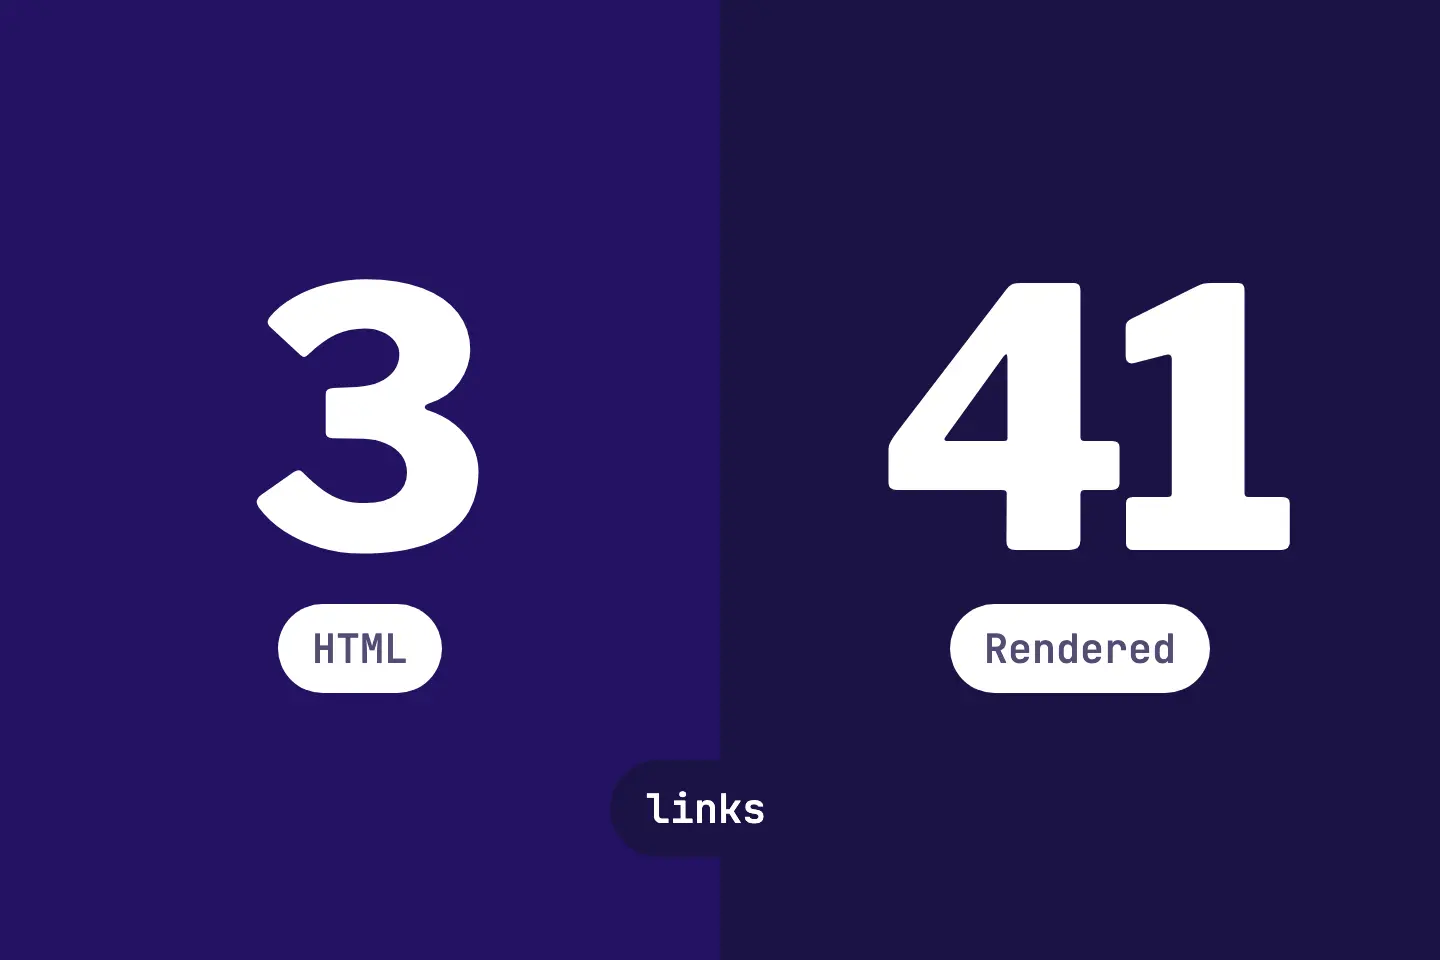
Moderne Websites laden Inhalte oft erst im Browser nach. Für Nutzer sieht die Seite korrekt aus. Für Crawler kann sie trotzdem fast leer sein.
Genau hier setzt die RankScan-Massnahme «Wenig Inhalt im ausgelieferten HyperText Markup Language (HTML) ist die Auszeichnungssprache für Webseiten. Mit ihr werden Struktur und Inhalt einer Seite definiert, etwa Überschriften, Absätze, Links und Bilder.Zum Glossareintrag → – JavaScript-Rendering bezeichnet den Vorgang, bei dem ein Browser oder Crawler JavaScript-Code ausführt, um daraus die fertige, sichtbare Seite zu erzeugen. Erst nach diesem Schritt entstehen Inhalte, die nicht bereits im ausgelieferten HTML stehen.Zum Glossareintrag → prüfen» an.
RankScan liest beim Beim Crawling ruft ein Suchmaschinen-Bot eine URL ab und lädt deren Inhalte herunter. Es ist der erste Schritt, bevor eine Seite indexiert werden kann.Zum Glossareintrag → das ausgelieferte HTML (Hypertext Markup Language, die Auszeichnungssprache für Webseiten). JavaScript führt RankScan dabei nicht aus. Enthält das ausgelieferte HTML einer Seite weniger als 50 Wörter, meldet RankScan sie. Das ist ein Hinweis auf mögliches Client-Rendering, keine Rendering-Messung. Wenige Wörter können auch andere Ursachen haben, etwa eine kurze Seite oder eine Fehlerseite.
Für klassische Suchmaschinenoptimierung (SEO) umfasst alle Maßnahmen, mit denen eine Website in den unbezahlten (organischen) Suchergebnissen besser sichtbar wird.Zum Glossareintrag → bedeutet das: Google muss die Seite nicht nur crawlen, sondern auch rendern.
Für die Sichtbarkeit bei Künstlicher Intelligenz (KI) bedeutet es: Viele KI-Crawler sehen möglicherweise nur das rohe HTML und damit nicht den eigentlichen Inhalt.
Wichtig ist die richtige Einordnung:
JavaScript ist nicht schlecht für SEO. Problematisch ist JavaScript dann, wenn wichtige Inhalte nur clientseitig entstehen und für Crawler nicht zuverlässig verfügbar sind.
In diesem Artikel erfährst du, wie JavaScript-SEO funktioniert, welche Rendering-Strategien sinnvoll sind, wie du prüfst, was Crawler wirklich sehen, und was du tust, wenn RankScan die Massnahme zeigt.
- JavaScript-SEO beschäftigt sich damit, ob Suchmaschinen und Crawler JavaScript-basierte (JS) Inhalte zuverlässig crawlen, rendern und Bei der Indexierung verarbeitet eine Suchmaschine gecrawlte Inhalte und entscheidet, ob eine URL in den Suchindex aufgenommen wird. Nur indexierte Seiten können in den Suchergebnissen erscheinen.Zum Glossareintrag → können.
- Google kann JavaScript rendern, aber Rendering ist ein zusätzlicher Verarbeitungsschritt.
- Inhalte, die im initialen HTML fehlen, sind riskanter als serverseitig ausgelieferte Inhalte.
- Viele KI-Crawler sind automatisierte Bots, die Webseiten für KI-Anbieter abrufen, um Inhalte zu finden, für Suchfunktionen bereitzustellen, für Antworten abzurufen oder je nach Anbieter für Modelltraining zu verwenden.Zum Glossareintrag → rendern JavaScript nicht oder nur eingeschränkt.
- Reines Beim Client-Side Rendering (CSR) liefert der Server nur ein nahezu leeres HTML-Grundgerüst. Der eigentliche Inhalt wird erst im Browser durch JavaScript erzeugt.Zum Glossareintrag → ist für SEO- und KI-Sichtbarkeit beschreibt, ob und wie sichtbar eine Marke, Website oder Person in KI-generierten Antworten ist. Sie misst Erwähnung, Position, Beschreibung und Quellenverlinkung über mehrere Plattformen und Prompts hinweg.Zum Glossareintrag → oft problematisch.
- Beim Server-Side Rendering (SSR) erzeugt der Server das fertige HTML, bevor die Seite an Browser oder Crawler ausgeliefert wird. Inhalte sind dadurch sofort im Quelltext vorhanden.Zum Glossareintrag →, Static Site Generation und gutes Prerendering sind meist deutlich crawlerfreundlicher.
- Dynamic Rendering ist laut Google ein Workaround und keine empfohlene langfristige Lösung.
- Wichtige Inhalte, Interne Verlinkung bezeichnet Links, die Seiten innerhalb derselben Website miteinander verbinden. Sie steuern, wie Suchmaschinen und Nutzer Inhalte finden und thematisch einordnen.Zum Glossareintrag →, Title, Die Meta-Description ist ein HTML-Element im <head> einer Seite, das deren Inhalt kurz zusammenfasst. Google kann sie als Beschreibung im Suchergebnis anzeigen.Zum Glossareintrag →, Der Canonical-Tag ist ein HTML-Link-Element, das Suchmaschinen die bevorzugte (kanonische) URL einer Seite mitteilt. Er hilft, doppelte oder ähnliche URLs auf eine Hauptversion zu bündeln.Zum Glossareintrag → und JSON-LD (JavaScript Object Notation for Linked Data) ist ein Datenformat, mit dem strukturierte Daten getrennt vom sichtbaren HTML in eine Seite eingebunden werden. Google empfiehlt es, wenn es technisch möglich ist.Zum Glossareintrag → (JavaScript Object Notation (JSON) ist ein leichtgewichtiges, textbasiertes Datenformat zum Speichern und Austauschen von Daten. Es ist für Menschen lesbar und für Maschinen gut verarbeitbar.Zum Glossareintrag → for Linked Data, ein Datenformat für Schema Markup ist Code, der den Inhalt einer Webseite strukturiert beschreibt, sodass Suchmaschinen ihn nicht nur als Text, sondern als eindeutige Informationen verstehen.Zum Glossareintrag →) sollten serverseitig im HTML verfügbar sein.
- RankScan meldet eine Seite, wenn ihr ausgeliefertes HTML weniger als 50 Wörter Text enthält. Das ist ein Hinweis auf mögliches Client-Rendering, keine Rendering-Messung. Rechts-, System- und Bestätigungsseiten zählen nicht.
- Einstufung in RankScan: Schwere mittel · Aufwand mittel · Arbeitsart Entwicklung.
Was bedeutet JavaScript-SEO? #
JavaScript-SEO umfasst alle technischen Massnahmen, die sicherstellen, dass JavaScript-basierte Websites von Suchmaschinen korrekt verarbeitet werden können.
Google beschreibt in der eigenen Dokumentation, dass Google Search JavaScript verarbeitet und dass Website-Betreiber sicherstellen sollen, dass Inhalte, Links und Metadaten für Google zugänglich sind.
Quelle: Google Search Central: Understand JavaScript SEO Basics
JavaScript-SEO ist besonders relevant bei:
- Single-Page Applications,
- React-, Vue- oder Angular-Websites,
- Headless-Setups eines Content-Management-Systems (Ein Content-Management-System (CMS) ist eine Software zur Erstellung, Verwaltung und Veröffentlichung von Webinhalten, meist ohne Programmierkenntnisse. Bekannte Beispiele sind WordPress oder Shopify.Zum Glossareintrag →), eines Systems zur Verwaltung von Webinhalten,
- Shop-Frontends,
- Produktfiltern,
- Dokumentationen,
- SaaS-Websites,
- interaktiven Landingpages,
- Websites mit nachgeladenen Inhalten,
- Seiten mit clientseitig erzeugten Meta-Daten.
Was bedeutet «Wenig Inhalt im ausgelieferten HTML – Rendering prüfen»? #
Die RankScan-Massnahme «Wenig Inhalt im ausgelieferten HTML – Rendering prüfen» bedeutet: Das ausgelieferte HTML der betroffenen Seiten enthält weniger als 50 Wörter Text. Der Titel nennt die Messung. RankScan zählt nur die Wörter im ausgelieferten HTML und stellt keine Rendering-Diagnose.
Wenige Wörter sind ein Hinweis auf mögliches Client-Rendering. Andere Ursachen sind ebenso möglich: Die Seite ist schlicht kurz, oder sie ist eine Fehlerseite, die mit Der HTTP-Status 200 (OK) bedeutet, dass eine Seite erfolgreich gefunden und ausgeliefert wurde. Nur 200-URLs sollten in der Sitemap stehen und als Canonical-Ziel dienen.Zum Glossareintrag → antwortet. Welche Ursache vorliegt, zeigt der Test mit ausgeschaltetem JavaScript.
Einstufung in RankScan: Schwere mittel · Aufwand mittel · Arbeitsart Entwicklung.
Was RankScan misst #
- RankScan zählt die Wörter im Text, den der Server ausliefert. JavaScript führt RankScan nicht aus.
- Gezählt wird der ganze Text der Seite, auch Navigation und Footer.
- Liegt eine erreichbare Seite (Statuscode 200) unter 50 Wörtern, zählt sie zur Massnahme.
- Rechts-, System- und Bestätigungsseiten zählen nicht mit, auch nicht in der Gesamtzahl der geprüften Seiten. Auf Login-, Konto- oder Passwortseiten ist JavaScript richtig.
- Den Seitentyp bestimmt RankScan beim Crawl. Erkennt RankScan eine Systemseite nicht, lässt du sie selbst aus.
- Hat eine Seite 50 Wörter oder mehr, greift diese Massnahme nicht. Seiten mit weniger als 300 Wörtern im Hauptinhalt meldet RankScan je nach Seitentyp zusätzlich unter «Wenig Text im Hauptinhalt – Substanz prüfen». Das gilt auch für Seiten unter 50 Wörtern.
Die Massnahme zählt nur die Wörter im ausgelieferten HTML. JavaScript-Fehler, blockierte Ressourcen und den Unterschied zwischen Quelltext und gerendertem Das Document Object Model (DOM) ist die strukturierte Abbildung einer Webseite, mit der ein Browser deren Inhalt und Aufbau im Speicher darstellt. JavaScript kann das DOM verändern und so Inhalte hinzufügen oder entfernen.Zum Glossareintrag → prüfst du mit den Tests weiter unten. Dort prüfst du auch, ob Title, Canonical, Links oder JSON-LD erst per JavaScript entstehen.
Wenig Text im HTML ist ein Hinweis auf mögliches Client-Side Rendering, aber kein Beweis. Eine kurze Seite oder eine Fehlerseite ohne JavaScript fällt ebenfalls unter die Massnahme. Deshalb öffnest du die Seiten zuerst mit ausgeschaltetem JavaScript.
Welche Elemente fachlich betroffen sein können #
Fachlich kann JavaScript-Rendering diese Elemente betreffen:
- Die H1 ist die Hauptüberschrift einer Webseite. Sie benennt das zentrale Thema, ist für Nutzer sichtbar und sollte pro Seite in der Regel nur einmal vorkommen.Zum Glossareintrag →,
- Haupttext,
- Produktinformationen,
- Preise,
- Kategorien,
- interne Links,
- Canonical-Tags,
- Title-Tags,
- Meta-Descriptions,
- JSON-LD,
- Eine Breadcrumb-Navigation zeigt den Pfad einer Seite innerhalb der Website-Hierarchie an. Sie verbessert die Orientierung der Nutzer und ergänzt die interne Verlinkung.Zum Glossareintrag →,
- FAQ-Inhalte (Frequently Asked Questions, also häufig gestellte Fragen),
- Paginierung,
- Filter-Links,
- Navigation.
Nicht jedes JavaScript ist problematisch. Unkritisch sind oft:
- Animationen,
- Tracking,
- Menüs,
- kleine Interaktionen,
- Formularvalidierung,
- Warenkorb-Interaktion,
- Personalisierung nach Login.
Kritisch wird es, wenn der Kerninhalt der Seite erst im Browser entsteht.
Warum JavaScript-Rendering für SEO riskant ist #
Suchmaschinen müssen bei JavaScript-Websites mehr tun als bei klassischen HTML-Seiten.
Bei einer klassischen Seite erhält der Crawler direkt:
<h1>SEO-Beratung für KMU</h1>
<p>Wir unterstützen Unternehmen bei technischer SEO, Content und Monitoring.</p>
<a href="/kontakt">Kontakt aufnehmen</a>
Bei einer reinen Client-Side-App erhält der Crawler möglicherweise nur:
<div id="app"></div>
<script src="/app.js"></script>
Der eigentliche Inhalt entsteht erst, wenn JavaScript geladen, ausgeführt und Daten von Programmierschnittstellen (APIs, kurz für Application Programming Interface) geholt wurden.
Das ist riskant, weil:
- Rendering zusätzliche Ressourcen braucht,
- JavaScript fehlschlagen kann,
- APIs blockiert oder langsam sein können,
- Inhalte verspätet erkannt werden,
- interne Links erst später sichtbar werden,
- Crawler nicht immer wie ein echter Browser handeln,
- KI-Crawler häufig gar nicht rendern.
Wie Google JavaScript verarbeitet #
Google kann JavaScript verarbeiten. Trotzdem ist es sinnvoll, wichtige Inhalte so früh und einfach wie möglich bereitzustellen.
Google erklärt, dass Google Search Seiten crawlt, rendert und indexiert. JavaScript kann dabei verarbeitet werden, aber Website-Betreiber sollten sicherstellen, dass Inhalte im gerenderten HTML sichtbar sind und Ressourcen nicht blockiert werden.
Quelle: Google Search Central: Understand JavaScript SEO Basics
Wichtig für die Praxis:
- Google kann JavaScript ausführen.
- Google muss die Ressourcen abrufen dürfen.
- Google muss Eine Application Programming Interface (API) ist eine Programmierschnittstelle, über die Software-Systeme miteinander kommunizieren und Daten austauschen. Sie definiert, wie Anfragen gestellt und beantwortet werden.Zum Glossareintrag →-Inhalte laden können.
- Fehler im JavaScript können Inhalte unsichtbar machen.
- Rendering ist ein zusätzlicher Schritt.
- Das initiale HTML bleibt für schnelle und robuste Erfassung wichtig.
Die alte Vorstellung einer strikt getrennten «Two-Wave Indexing»-Logik wird heute oft zu absolut dargestellt. Praktisch bleibt aber richtig: JavaScript-Rendering ist komplexer und fehleranfälliger als serverseitig ausgeliefertes HTML.
KI-Crawler und JavaScript: Vorsichtig planen #
Bei KI-Crawlern ist die Lage uneinheitlicher als bei Google.
OpenAI dokumentiert verschiedene Crawler und User-Agents, darunter GPTBot ist der von OpenAI dokumentierte Crawler, der typischerweise für das Training künftiger Modelle Inhalte abruft. Er lässt sich über robots.txt gezielt erlauben oder blockieren.Zum Glossareintrag →, OAI-SearchBot ist der von OpenAI dokumentierte Crawler für ChatGPT Search. Er ruft Inhalte ab, damit öffentliche Websites als Quelle in ChatGPT-Zusammenfassungen, Snippets und Antworten erscheinen können.Zum Glossareintrag → und ChatGPT-User ist der von OpenAI dokumentierte User-Agent für nutzerinitiierte Abrufe. Er ruft eine Seite ab, wenn ein Nutzer in ChatGPT eine konkrete URL oder Anfrage eingibt.Zum Glossareintrag →. Diese erfüllen unterschiedliche Zwecke und können über robots.txt gesteuert werden.
Quelle: OpenAI Platform: Overview of OpenAI Crawlers
Die OpenAI-Dokumentation sagt jedoch nicht, dass diese Crawler JavaScript wie ein Browser rendern. Deshalb solltest du für KI-Sichtbarkeit nicht davon ausgehen, dass clientseitig nachgeladene Inhalte zuverlässig gelesen werden.
Vercel veröffentlichte 2024 eine Analyse zu AI-Crawlern (AI, englisch für Künstliche Intelligenz) und JavaScript-Rendering. Laut dieser Untersuchung rendern grosse AI-Crawler wie OpenAI, Anthropic oder Meta JavaScript nicht wie klassische Browser.
Quelle: Vercel: The rise of the AI crawler
Daraus folgt:
Wenn wichtige Inhalte erst durch Client-Side Rendering entstehen, sind sie für viele KI-Crawler potenziell unsichtbar.
Das ist kein Beweis, dass jede KI deine Seite ignoriert. Aber es ist ein starkes technisches Risiko.
Client-Side Rendering, Server-Side Rendering und Prerendering #
Die Rendering-Strategie entscheidet, wann und wo HTML entsteht.
| Strategie | Funktionsweise | SEO-/Crawler-Eignung |
|---|---|---|
| Client-Side Rendering | Server liefert leeres HTML, Browser baut Inhalt per JS auf | riskant für SEO und KI-Crawler |
| Server-Side Rendering | Server liefert fertiges HTML pro Anfrage | sehr gut für dynamische Inhalte |
| Static Site Generation | HTML wird beim Build erzeugt | sehr gut für Blogs, Dokus, Ratgeber |
| Incremental Static Regeneration | statisches HTML wird periodisch oder bei Bedarf erneuert | gut für grössere Websites mit Aktualisierungen |
| Prerendering | fertiges HTML wird für bestimmte URLs vorbereitet | gut als Übergang oder für statische Inhalte |
| Edge Rendering | HTML wird serverseitig am Ein Content Delivery Network (CDN) ist ein Netzwerk verteilter Server, das statische Inhalte näher beim Nutzer ausliefert und so Ladezeiten verkürzt.Zum Glossareintrag → (CDN, ein Netzwerk verteilter Server zur schnelleren Auslieferung) bzw. am Edge erzeugt | sehr gut, wenn sauber implementiert |
| Dynamic Rendering | Bots erhalten andere gerenderte Version als Nutzer | Workaround, nicht langfristige Empfehlung |
Client-Side Rendering: Wann es problematisch wird #
Client-Side Rendering (CSR), also das Rendern im Browser, bedeutet: Der Server liefert nur ein Grundgerüst. Der Browser lädt JavaScript und erzeugt daraus die Seite.
Beispiel:
<!doctype html>
<html>
  <head>
    <title>SaaS Tool</title>
  </head>
  <body>
    <div id="root"></div>
    <script src="/bundle.js"></script>
  </body>
</html>
Für Nutzer kann das perfekt funktionieren. Für Crawler ist es riskant.
Problematisch ist CSR besonders, wenn:
- H1 fehlt im initialen HTML,
- Hauptinhalt fehlt im initialen HTML,
- Produktdaten erst per API kommen,
- interne Links erst per JS erzeugt werden,
- Meta-Daten clientseitig gesetzt werden,
- Canonicals clientseitig gesetzt werden,
- JSON-LD clientseitig injiziert wird,
- Inhalte erst nach Scroll, Klick oder Nutzerinteraktion geladen werden.
Server-Side Rendering: Die robuste Lösung #
Server-Side Rendering (SSR), also serverseitiges Rendern, bedeutet: Der Server erzeugt das fertige HTML, bevor die Seite an Browser oder Crawler ausgeliefert wird.
Beispiel:
<h1>JavaScript-SEO: Rendering-Probleme erkennen</h1>
<p>Dieser Guide erklärt, wie Inhalte für Google und KI-Crawler sichtbar bleiben.</p>
<a href="/kontakt">Kontakt aufnehmen</a>
Vorteile:
- Inhalte sind sofort im HTML,
- Crawler sehen Kerninhalte ohne Browser-Rendering,
- Meta-Daten sind direkt verfügbar,
- interne Links sind crawlbar,
- strukturierte Daten können serverseitig ausgegeben werden,
- bessere Basis für Performance und Core Web Vitals.
SSR ist besonders sinnvoll für:
- SaaS-Websites,
- Shops,
- Produktseiten,
- Kategorien,
- Ratgeber,
- Dokumentationen,
- News,
- wichtige Landingpages.
Static Site Generation und Prerendering #
Static Site Generation (SSG), also die statische Seitengenerierung, erzeugt fertige HTML-Dateien beim Build. Das eignet sich besonders für Inhalte, die sich nicht bei jedem Aufruf ändern.
Gut geeignet für:
- Blogartikel,
- Ratgeber,
- Dokumentationen,
- Glossare,
- Marketingseiten,
- Help Center,
- Landingpages.
Prerendering erzeugt HTML-Versionen von Seiten im Voraus oder bei Bedarf. Es kann eine sinnvolle Übergangslösung sein, wenn eine bestehende CSR-App nicht sofort auf SSR umgestellt werden kann.
Wichtig:
- prerendered HTML muss dem sichtbaren Inhalt entsprechen,
- keine veralteten Snapshots ausliefern,
- Canonicals und Meta-Daten müssen stimmen,
- interne Links müssen enthalten sein,
- Bot-Version und Nutzer-Version dürfen nicht inhaltlich widersprechen.
Dynamic Rendering: Warum es nur ein Workaround ist #
Dynamic Rendering bedeutet: Nutzer erhalten die normale JavaScript-App, Crawler erhalten eine gerenderte HTML-Version.
Google beschreibt Dynamic Rendering als Workaround für Websites, bei denen JavaScript-generierter Inhalt für Suchmaschinen nicht verfügbar ist. Google weist aber auch darauf hin, dass Dynamic Rendering keine empfohlene Lösung ist, weil es zusätzliche Komplexität und Ressourcen benötigt.
Quelle: Google Search Central: Dynamic Rendering as a workaround
Warum Dynamic Rendering problematisch ist:
- zwei Versionen müssen gepflegt werden,
- Bot-Erkennung ist fehleranfällig,
- neue KI-Crawler werden oft nicht erfasst,
- Inhalte können zwischen Nutzer- und Bot-Version abweichen,
- Cloaking-Risiko bei falscher Umsetzung,
- komplexes Monitoring.
Besser sind in den meisten Fällen:
- SSR,
- SSG,
- Incremental Static Regeneration (ISR),
- Edge Rendering,
- sauberes Prerendering.
Hydration: Wenn HTML interaktiv wird #
Viele moderne Frameworks kombinieren SSR oder SSG mit Hydration bezeichnet den Vorgang, bei dem serverseitig geliefertes HTML im Browser durch JavaScript interaktiv gemacht wird. Das Markup ist bereits vorhanden, JavaScript fügt nur noch das Verhalten hinzu.Zum Glossareintrag →.
Ablauf:
- Server liefert fertiges HTML.
- Crawler kann Inhalte lesen.
- Browser lädt JavaScript.
- JavaScript macht die Seite interaktiv.
Das ist grundsätzlich gut. Probleme entstehen, wenn Hydration fehlschlägt.
Typische Ursachen für Hydration-Probleme:
- serverseitig andere Daten als clientseitig,
Date.now()oder Zufallswerte im Render,- unterschiedliche Locale-Ausgaben,
- API-Daten nicht synchron,
- Nutzerzustand wird zu früh berücksichtigt,
- Komponenten rendern serverseitig anders als clientseitig.
Ein Hydration-Mismatch kann dazu führen, dass Inhalte flackern, verschwinden oder im Browser anders aussehen als im ausgelieferten HTML.
Framework-Hinweise: React, Vue, Angular, Astro und SvelteKit #
React / Next.js #
Next.js unterstützt SSR, SSG und moderne Server Components. Für SEO-relevante Seiten sollten Inhalte, Metadaten, Canonicals und strukturierte Daten serverseitig erzeugt werden.
Wichtig:
- nicht alle Inhalte nur im Client Component nachladen,
- Metadata API sauber nutzen,
- interne Links mit echten
<a href>ausgeben, - strukturierte Daten serverseitig einbetten.
Vue / Nuxt #
Reines Vue kann clientseitig rendern. Für gute Vue JS SEO ist Nuxt mit SSR oder SSG meist die bessere Grundlage.
Wichtig:
- Universal Rendering nutzen,
- Head-/Meta-Daten serverseitig setzen,
- API-Daten serverseitig laden,
- wichtige Inhalte im initialen HTML ausgeben.
Angular #
Aktuelles Angular unterstützt Server- und Hybrid-Rendering über das Paket @angular/ssr. Du richtest es mit ng add @angular/ssr ein. Bestehende Projekte mit Angular Universal betrachtest du je nach verwendeter Angular-Version.
Quelle: Angular: Server and hybrid rendering
Ohne SSR besteht bei reinen Angular-SPAs (Single Page Application) das Risiko, dass Inhalte erst clientseitig entstehen.
Astro #
Astro ist für contentlastige Websites stark, weil standardmässig wenig JavaScript ausgeliefert wird. Interaktive Komponenten können als Inseln eingebunden werden.
SvelteKit #
SvelteKit unterstützt SSR standardmässig. Wichtig ist, SSR nicht unbeabsichtigt für SEO-relevante Seiten zu deaktivieren.
Was muss im initialen HTML stehen? #
Für SEO- und KI-Sichtbarkeit sollten diese Elemente möglichst im initialen HTML vorhanden sein:
- Der Title-Tag ist ein HTML-Element im <head> einer Seite, das den Seitentitel definiert. Er erscheint im Browser-Tab und kann als klickbarer Titel im Suchergebnis verwendet werden.Zum Glossareintrag →,
- Meta-Description,
- Canonical,
- H1,
- Haupttext,
- wichtige H2/H3,
- interne Links,
- Navigation,
- Breadcrumbs,
- Produktname,
- Preis und Verfügbarkeit,
- zentrale Bilder mit Ein Alt-Text ist eine Textalternative für ein Bild, die im alt-Attribut des img-Elements hinterlegt wird und Inhalt oder Funktion des Bildes beschreibt.Zum Glossareintrag →,
- strukturierte Daten,
- FAQ-Inhalte,
- Autorinformationen,
- Pagination-Links,
- hreflang ist ein HTML-Attribut, das Suchmaschinen die Sprache und Region einer Seite mitteilt. Es verknüpft sprachliche oder regionale Varianten derselben Inhalte miteinander.Zum Glossareintrag →-Links.
Nicht alles muss ohne JavaScript perfekt interaktiv sein. Aber die Bedeutung der Seite sollte ohne JavaScript erkennbar bleiben.
Echte Links statt JavaScript-Navigation #
Crawler brauchen echte Links.
Schlecht:
<button onclick="goTo('/leistungen')">Leistungen</button>Besser:
<a href="/leistungen">Leistungen</a>Google empfiehlt für Links ein <a>-Element mit href-Attribut, damit Google Links zuverlässig crawlen kann.
Quelle: Google Search Central: Links best practices
Das gilt besonders für:
- Hauptnavigation,
- Teaser,
- Produktkarten,
- Pagination,
- Breadcrumbs,
- interne Links im Content,
- Filterseiten mit SEO-Relevanz.
Meta-Daten und strukturierte Daten serverseitig setzen #
Title, Meta-Description, Canonical und JSON-LD sollten nicht erst nachträglich im Browser entstehen.
Problematisch:
document.title = 'Neue Seite';oder JSON-LD nur per Tag Manager nachladen.
Besser:
- Title im serverseitigen Head ausgeben,
- Meta-Description im HTML ausgeben,
- Canonical serverseitig setzen,
- hreflang serverseitig setzen,
- JSON-LD direkt im HTML ausgeben.
Warum?
Crawler und KI-Systeme können dann die wichtigsten Signale ohne Rendering erfassen.
Lazy Loading, Tabs und Accordions #
JavaScript ist nicht nur beim ersten Rendern relevant. Auch spätere Interaktionen können Inhalte verstecken.
Lazy Loading #
Gut für:
- Bilder unterhalb des sichtbaren Bereichs,
- Videos,
- nicht kritische Module.
Riskant für:
- H1,
- Haupttext,
- Produktdaten,
- wichtige interne Links,
- Preise,
- FAQ-Inhalte.
Tabs und Accordions #
Unkritisch, wenn Inhalte bereits im HTML stehen und nur ein- oder ausgeblendet werden.
Riskant, wenn Inhalte erst nach Klick per API geladen werden.
Infinite Scroll #
Problematisch, wenn keine crawlbaren Pagination-URLs existieren.
Besser:
- eigenständige URLs,
- Pagination-Links,
- History API sauber nutzen,
- Inhalte serverseitig verfügbar machen.
Wie du prüfst, was Crawler sehen #
1. Quelltext anzeigen #
Im Browser:
Rechtsklick → Seitenquelltext anzeigenSuche nach:
- H1,
- Haupttext,
- Produktname,
- Preis,
- internen Links,
- Canonical,
- JSON-LD.
Wichtig: «Seitenquelltext anzeigen» ist nicht dasselbe wie «Untersuchen». DevTools zeigt oft das bereits gerenderte Document Object Model (DOM), also die Struktur, mit der der Browser eine Seite abbildet.
2. JavaScript deaktivieren #
Deaktiviere JavaScript im Browser und lade die Seite neu.
Prüfe:
- Ist der Hauptinhalt sichtbar?
- Sind Links erreichbar?
- Ist Navigation vorhanden?
- Sind wichtige Texte lesbar?
- Gibt es eine leere Seite?
Das simuliert nicht perfekt jeden Crawler, zeigt aber typische Risiken.
3. Google Search Console URL-Prüfung #
Nutze das URL-Prüftool und den Live-Test.
Prüfe:
- Screenshot,
- gerendertes HTML,
- geladene Ressourcen,
- blockierte Ressourcen,
- Indexierbarkeit,
- JavaScript-Fehler.
4. cURL-Test #
Rufe die Seite ohne Browser auf:
curl -L https://example.ch/Suche im Output nach Hauptinhalten.
Dieser Test zeigt, was einfache HTML-Clients und viele Bots zuerst erhalten.
5. Logfiles prüfen #
Server-Logs zeigen, welche Bots deine Seite abrufen und welche Statuscodes sie erhalten.
Prüfe:
- Der Googlebot ist der Webcrawler von Google, der Webseiten abruft, um sie für die Google-Suche zu crawlen und zu indexieren.Zum Glossareintrag →,
- GPTBot,
- OAI-SearchBot,
- ChatGPT-User,
- ClaudeBot ist der von Anthropic genutzte Web-Crawler. Website-Betreiber können seinen Zugriff über die robots.txt steuern und bei Bedarf blockieren.Zum Glossareintrag →,
- PerplexityBot ist der von Perplexity dokumentierte Crawler, der Websites in Perplexity-Suchergebnissen sichtbar machen und als Quelle verlinken soll. Laut Perplexity wird er nicht für das Training von Foundation Models genutzt.Zum Glossareintrag →,
- Statuscodes,
- Antwortgrössen,
- blockierte Ressourcen,
- 403/429-Fehler.
Einordnung: Welche JavaScript-SEO-Probleme sind kritisch? #
Die folgende Tabelle ist eine allgemeine fachliche Einordnung. RankScan zeigt für die Massnahme eine einzige Schwere: mittel. Die Massnahme ist ein Hinweis, kein Beleg für ein Rendering-Problem.
| Problem | Gewicht | Warum |
|---|---|---|
| Hauptinhalt fehlt im initialen HTML | Hoch | Crawler sehen Kerninhalt evtl. nicht |
| interne Links nur per JavaScript | Hoch | Crawling und Linksignale geschwächt |
| Title/Canonical clientseitig gesetzt | Hoch | wichtige SEO-Signale unsicher |
| Produktdaten nur per API im Browser | Hoch | Shop-Sichtbarkeit gefährdet |
| JSON-LD nur clientseitig injiziert | Mittel bis hoch | Structured Data unsicher |
| Navigation ohne echte href-Links | Hoch | Crawl-Pfade fehlen |
| FAQ erst nach Klick geladen | Mittel | Inhalte nicht zuverlässig sichtbar |
| Animationen per JavaScript | Niedrig | meist unkritisch |
| Tracking per JavaScript | Niedrig | kein SEO-Kernproblem |
| Personalisierte Nutzerbereiche | Niedrig bis mittel | abhängig von Indexierungsziel |
Die wichtigste Regel:
Alles, was für Ranking, Verständnis, interne Verlinkung oder Conversion wichtig ist, sollte nicht ausschliesslich clientseitig erzeugt werden.
Content-Fehler oder Architektur-Fehler? #
Bei «Wenig Inhalt im ausgelieferten HTML – Rendering prüfen» ist meist nicht der Text das Problem, sondern die Auslieferung.
Content-/Komponentenproblem #
Beispiele:
- FAQ-Komponente lädt Antworten erst nach Klick,
- Produktpreise kommen nur clientseitig,
- Filterlinks sind Buttons ohne
href, - Autorenbox wird erst im Browser eingefügt,
- JSON-LD kommt nur über Tag Manager.
Lösung: Komponente serverseitig oder statisch ausgeben.
Architekturproblem #
Beispiele:
- komplette Website ist CSR,
- Marketingseiten sind in einer SPA ohne SSR,
- Headless-Shop rendert nur im Browser,
- Dokumentation wird per JS aus API gebaut,
- Prerendering fehlt oder ist veraltet.
Lösung: SSR, SSG, ISR, Prerendering oder Architekturänderung.
Architekturprobleme wiegen meist schwerer, weil sie viele URLs betreffen.
Vorgehen, wenn RankScan die Massnahme zeigt #
Die Schritte folgen der Massnahme in RankScan. Die Fachhinweise ergänzen sie.
Schritt 1: Systemseiten auslassen #
Prüfe zuerst, ob eine Seite eine Systemseite ist: Login, Konto, Passwort oder Formularstatus. Dort ist JavaScript richtig. Lass diese Seiten aus.
Schritt 2: Seiten ohne JavaScript öffnen und notieren, was fehlt #
Öffne die übrigen Seiten mit ausgeschaltetem JavaScript. Notiere, was fehlt:
- Fehlt der Haupttext?
- Fehlt die H1?
- Fehlen interne Links?
- Fehlen Produktdaten?
- Fehlen Meta-Daten?
- Fehlt JSON-LD?
- Fehlt Navigation?
- Fehlen FAQ-Inhalte?
Ist die Seite auch mit JavaScript fast leer, liegt kein Rendering-Problem vor. Dann fehlt schlicht Text auf der Seite.
Schritt 3: Liste an Entwicklung oder Agentur weitergeben #
Gib die Liste an Entwicklung oder Agentur weiter. Ordne sie nach Seitentyp. Besonders wichtig sind:
- Startseite,
- Leistungsseiten,
- Produktseiten,
- Kategorien,
- Ratgeberartikel,
- Dokumentation,
- Landingpages,
- Standortseiten,
- FAQ- und Help-Seiten.
Nenne dazu die Rendering-Strategie der Website, soweit du sie kennst:
CSR, SSR, SSG, ISR, Prerendering oder Edge Rendering?
Werden SEO-relevante Seiten rein clientseitig gerendert, braucht es meist eine robustere Strategie.
Schritt 4: Inhalte serverseitig oder per Pre-Rendering ausliefern #
Lass die Inhalte serverseitig oder per Pre-Rendering ausliefern. Je nach Ursache reicht ein Quick Fix, oder es braucht einen Architektur-Fix:
| Situation | Lösung |
|---|---|
| einzelne Komponente fehlt im HTML | Komponente serverseitig ausgeben |
| Meta-Daten clientseitig | Head serverseitig rendern |
| Links sind Buttons | echte <a href>-Links verwenden |
| JSON-LD nur im Google Tag Manager (GTM) | JSON-LD ins HTML einbauen |
| komplette SPA | SSR/SSG/Prerendering prüfen |
| bestehende App kann nicht migrieren | Prerendering als Übergang |
| Bot-Version weicht ab | Inhalt angleichen, Cloaking-Risiko prüfen |
Schritt 5: Prüfen und als umgesetzt melden #
Prüfe nach dem Fix:
- Quelltext,
- Seite mit ausgeschaltetem JavaScript,
- Live-Test der Die Google Search Console (GSC) ist ein kostenloses Google-Tool, das zeigt, wie eine Website in der organischen Suche performt, mit Daten zu Impressionen, Klicks, Klickrate und durchschnittlicher Position sowie zu Indexierung und technischen Problemen.Zum Glossareintrag →,
- cURL,
- Logfiles.
Melde die Massnahme als umgesetzt, sobald die Inhalte ohne JavaScript erscheinen.
Prüfweg: Der nächste vollständige Crawl prüft alle betroffenen Seiten. RankScan meldet dann «Behoben» oder «Noch nicht behoben» mit der Zahl der Seiten, die noch unter 50 Wörtern liegen.
Allgemeine Checkliste: Worauf ein guter JavaScript-SEO-Check achtet #
Diese Liste ist eine allgemeine fachliche Checkliste. RankScan misst davon nur einen Punkt: ob das ausgelieferte HTML mindestens 50 Wörter Text enthält. Die übrigen Punkte prüfst du selbst, etwa mit den Tests oben.
Ein guter Check meldet nicht nur, dass JavaScript vorhanden ist. Entscheidend ist, ob wichtige Inhalte erst durch JavaScript entstehen.
Ein guter Check umfasst:
- Hauptinhalt im initialen HTML,
- H1 im initialen HTML,
- Title und Meta-Description serverseitig,
- Canonical serverseitig,
- JSON-LD im HTML,
- echte interne Links mit
href, - Navigation crawlbar,
- Produktdaten im HTML,
- Breadcrumbs im HTML,
- FAQ-Inhalte im HTML,
- Unterschied zwischen Quelltext und gerendertem DOM,
- blockierte JS- bzw. Cascading Style Sheets (CSS) ist die Sprache, mit der das Layout und die Gestaltung von Webseiten festgelegt werden. CSS bestimmt unter anderem Farben, Schriften, Abstände und Anordnung.Zum Glossareintrag →-Ressourcen (Cascading Style Sheets, die Sprache für das Layout von Webseiten),
- JavaScript-Fehler beim Rendering,
- API-Abhängigkeiten,
- HTTP (Hypertext Transfer Protocol) ist das Protokoll, über das Browser und Server Webinhalte austauschen. HTTPS ist die verschlüsselte, sichere Variante dieses Protokolls.Zum Glossareintrag →-Statuscodes (Hypertext Transfer Protocol) für Bots,
- AI-Crawler-Zugriffe in Logs,
- CSR-Muster wie leeres
div#app.
Beispiel: Unsichtbare SaaS-Landingpage #
Ausgangslage #
Ein SaaS-Anbieter betreibt seine Marketingseite als reine React-SPA.
Der Quelltext zeigt:
<body>
  <div id="root"></div>
  <script src="/bundle.js"></script>
</body>
Im Browser sieht die Seite vollständig aus. Das ausgelieferte HTML enthält aber kaum Text. RankScan führt die Seite deshalb unter anderem in diesen Massnahmen:
«Wenig Inhalt im ausgelieferten HTML – Rendering prüfen»
«Seiten ohne Hauptüberschrift (H1)»
Einstufung der ersten Massnahme: Schwere mittel · Aufwand mittel · Entwicklung
Analyse #
Der Test mit ausgeschaltetem JavaScript und der Blick in den Quelltext zeigen:
- H1 fehlt im initialen HTML,
- Leistungsbeschreibung fehlt im initialen HTML,
- interne Links werden per Button-Navigation erzeugt,
- JSON-LD wird clientseitig eingefügt,
- KI-Crawler erhalten nur eine fast leere HTML-Hülle.
Lösung #
- Marketingseiten auf SSR oder SSG umstellen.
- H1, Haupttext und interne Links serverseitig ausgeben.
- Title, Description und Canonical im HTML setzen.
- JSON-LD serverseitig integrieren.
- App nach dem Laden hydrieren.
- Mit cURL und dem Live-Test der GSC prüfen.
- Die Massnahme als umgesetzt melden. Der nächste vollständige Crawl prüft die Seite.
Ergebnis #
Crawler erhalten direkt verständliches HTML. Die Seite ist robuster für Google, klassische Crawler und KI-Systeme.
Häufige Fehler bei JavaScript-SEO #
Fehler 1: Browseransicht mit Bot-Sicht verwechseln #
Nur weil die Seite im Browser funktioniert, ist sie nicht automatisch crawlbar.
Fehler 2: DevTools statt Quelltext prüfen #
DevTools zeigt das gerenderte DOM. Für den ersten Bot-Eindruck ist der rohe Quelltext entscheidend.
Fehler 3: Interne Links als Buttons bauen #
Ohne echte href-Links fehlen crawlbare Pfade.
Fehler 4: Meta-Daten clientseitig setzen #
SEO-Signale sollten nicht erst nach JavaScript-Ausführung entstehen.
Fehler 5: Hauptinhalt nach Scroll oder Klick laden #
Crawler interagieren nicht wie echte Nutzer. Wichtige Inhalte sollten nicht erst nach Nutzeraktion geladen werden.
Fehler 6: Dynamic Rendering dauerhaft als Lösung nutzen #
Dynamic Rendering kann helfen, ist aber komplex und laut Google nicht die empfohlene langfristige Lösung.
Fehler 7: KI-Crawler ignorieren #
Wer Inhalte nur clientseitig ausliefert, riskiert, dass viele KI-Crawler zentrale Inhalte nicht sehen.
Checkliste: JavaScript-SEO prüfen #
Nutze diese Checkliste:
- Ist der Hauptinhalt im Seitenquelltext vorhanden?
- Ist die H1 im initialen HTML?
- Sind Title, Description und Canonical serverseitig gesetzt?
- Sind wichtige interne Links echte
<a href>-Links? - Ist JSON-LD im HTML vorhanden?
- Sind Produktdaten im HTML?
- Sind Preise und Verfügbarkeit im HTML?
- Sind FAQ-Inhalte ohne Klick sichtbar oder im HTML vorhanden?
- Funktioniert die Seite mit deaktiviertem JavaScript grundsätzlich?
- Sieht Google im URL-Prüftool den Hauptinhalt?
- Gibt es blockierte JS- oder CSS-Ressourcen?
- Gibt es Rendering-Fehler?
- Gibt es leere App-Shells wie
<div id="app"></div>? - Gibt es Hinweise in Server-Logs, dass Bots nur kleine HTML-Antworten erhalten?
- Hast du Systemseiten wie Login oder Konto ausgelassen?
- Hast du die Massnahme in RankScan als umgesetzt gemeldet?
Ergänzend dazu helfen semantisches HTML und AI Readiness Score, um die Ursache sauber einzugrenzen und die nächsten SEO-Massnahmen zu priorisieren.
FAQ zu JavaScript-SEO #
Was ist JavaScript-SEO?
JavaScript-SEO beschreibt Massnahmen, die sicherstellen, dass Suchmaschinen Inhalte, Links und Metadaten auf JavaScript-Websites zuverlässig crawlen, rendern und indexieren können.
Kann Google JavaScript lesen?
Ja, Google kann JavaScript rendern. Trotzdem ist serverseitig verfügbares HTML robuster, schneller und weniger fehleranfällig.
Was ist Client-Side Rendering?
Beim Client-Side Rendering liefert der Server ein fast leeres HTML-Grundgerüst. Der Browser erzeugt die Inhalte erst durch JavaScript.
Was ist Server-Side Rendering?
Beim Server-Side Rendering erzeugt der Server fertiges HTML und sendet es direkt an Browser oder Crawler.
Was ist Prerendering?
Prerendering erzeugt fertige HTML-Versionen von Seiten vorab oder bei Bedarf. Es kann für bestehende CSR-Websites eine Übergangslösung sein.
Ist Dynamic Rendering noch empfehlenswert?
Google beschreibt Dynamic Rendering als Workaround und nicht als empfohlene Lösung. Langfristig sind SSR, SSG oder ähnliche Ansätze stabiler.
Können KI-Crawler JavaScript rendern?
Viele KI-Crawler rendern JavaScript nicht oder nur eingeschränkt. Deshalb sollten wichtige Inhalte im initialen HTML vorhanden sein.
Wie teste ich, was Crawler sehen?
Prüfe den Seitenquelltext, deaktiviere JavaScript, nutze die Google Search Console URL-Prüfung, teste mit curl und analysiere Server-Logs.
Muss jede Website SSR nutzen?
Nein. Wenn wichtige Inhalte bereits im HTML stehen, kann auch eine statische oder einfache Website gut funktionieren. Kritisch sind reine CSR-Seiten mit fehlendem Kerninhalt im HTML.
Was bedeutet «Wenig Inhalt im ausgelieferten HTML – Rendering prüfen» in RankScan?
Das ausgelieferte HTML der betroffenen Seiten enthält weniger als 50 Wörter Text. Das ist ein Hinweis auf mögliches Client-Rendering, keine Rendering-Messung. Es kann auch eine kurze Seite oder eine Fehlerseite sein. RankScan führt JavaScript nicht aus und misst nur die Wortzahl. Rechts-, System- und Bestätigungsseiten zählen nicht. Die Schwere ist mittel.
Fazit: Was nicht zuverlässig im HTML steht, ist ein Sichtbarkeitsrisiko #
JavaScript ist nicht der Gegner von SEO. Aber rein clientseitig erzeugte Inhalte sind ein Risiko.
Für Google bedeutet JavaScript zusätzlichen Rendering-Aufwand. Für viele KI-Crawler bedeutet es möglicherweise: Der Inhalt wird gar nicht gesehen.
Die RankScan-Massnahme «Wenig Inhalt im ausgelieferten HTML – Rendering prüfen» hat die Schwere mittel, denn wenig Text im HTML ist ein Hinweis, kein Beleg. Sie zeigt Seiten, deren ausgeliefertes HTML kaum Text enthält. Auf diesen Seiten entsteht der Inhalt möglicherweise erst nach dem Rendern. Ob das zutrifft, zeigt der Test mit ausgeschaltetem JavaScript.
Die beste Vorgehensweise lautet:
- Systemseiten auslassen und prüfen, was im initialen HTML steht,
- wichtige Inhalte und Links serverseitig verfügbar machen,
- Meta-Daten und Canonicals im HTML ausgeben,
- JSON-LD serverseitig integrieren,
- echte HTML-Links verwenden,
- Rendering-Fehler beheben,
- SSR, SSG, ISR oder Prerendering für wichtige Seiten nutzen,
- mit GSC, cURL und Logs prüfen,
- die Massnahme als umgesetzt melden; der nächste vollständige Crawl prüft die Seiten.
So wird JavaScript nicht zum Sichtbarkeitsproblem, sondern zu einer stabilen technischen Grundlage für SEO, Website Health und KI-lesbare Inhalte.